用 Meta Muse 做深度研究:我讓它查 Ghost Core 怎麼「記住你」
上一篇拆完 Ghost Core 這門生意,留下一個問題:它到底怎麼記住你?這次換 Meta Muse 的深度研究去查。這篇講三件事:Muse 的深度研究怎麼運作、跟 ChatGPT/Gemini 差在哪,以及這份報告的實際內容——它把資料分成已確認、二手、未公開三層,十個查不到的問題就老實寫查不到。結尾附一份照這份報告反推的研究提示詞。
上一篇,我們拆了 Ghost Core 這門生意。
拆完,留下一個問題。
它說要 24 小時記住你的生活。
那它到底怎麼記?記在哪?你想讓它忘掉的時候,它忘得掉嗎?
這次我換一個工具去查:Meta Muse 的深度研究。
先講結論:這份報告最值得學的,不是它查到了什麼,是它怎麼處理「查不到」。
Meta Muse 的深度研究怎麼運作
以下是 Muse 對自己的說明,我整理成重點:
- 深度研究是一個獨立的研究 agent。
- 它在「登出狀態」的瀏覽器裡跑公開網頁:看不到你跟 Muse 的對話、沒有你的記憶和帳號、不會登入任何網站。
- 跑完,把附來源的報告交回給 Muse,再由 Muse 整理給你。
- 限制很明確:要登入、或在付費牆後面的內容,它碰不到。
第三方評測也提到,Muse 的瀏覽器跑在隔離的虛擬機裡,你可以打開視窗看它在做什麼;它用過哪些技能,也能在 Activity log 查到(eesel)。
這直接決定你該拿它查什麼。
研究對象的關鍵資料如果在公開網頁上,像官網、隱私政策、新聞報導,它查得到。如果關鍵資料要登入才看得到,就得換別的方法。
Ghost Core 剛好是前者:官網、規格頁、隱私政策全部公開。
跟 ChatGPT/Gemini 的深度研究差在哪
我直接問了 Muse。
它的回答是:三家都是多步驟、自主查資料、產出附來源的長篇報告。真正的差別在工作流。
- 研究之後誰動手。 Muse 說,它的研究跑完直接回到它手上,可以接著做事:建文件、畫表格、去官網即時查驗、排後續追蹤。研究只是工作的一站。ChatGPT/Gemini 的產出是一份報告,後續要你自己動手,或另開話題。
- 記憶連續性。 研究結果會進到對話裡,Muse 是帶著對你的了解(你的專案、偏好、查證標準)來解讀。它形容另外兩家是單次交付,用完即走。
- 範圍控制。 一次只跑一個研究任務。有追加問題,就餵給同一個任務繼續深挖,不會另起爐灶、各說各話。
Muse 自己的總結是:「他們賣的是一份報告,我賣的是『研究完還站在你這邊的後續』。」
先講清楚:這是 Muse 對自己的描述,不是我把三家放在一起實測的結果。
把廠商的自我介紹直接當結論——這正好是下面這份報告教你不要做的事。
實際案例:Core 怎麼「記住你」
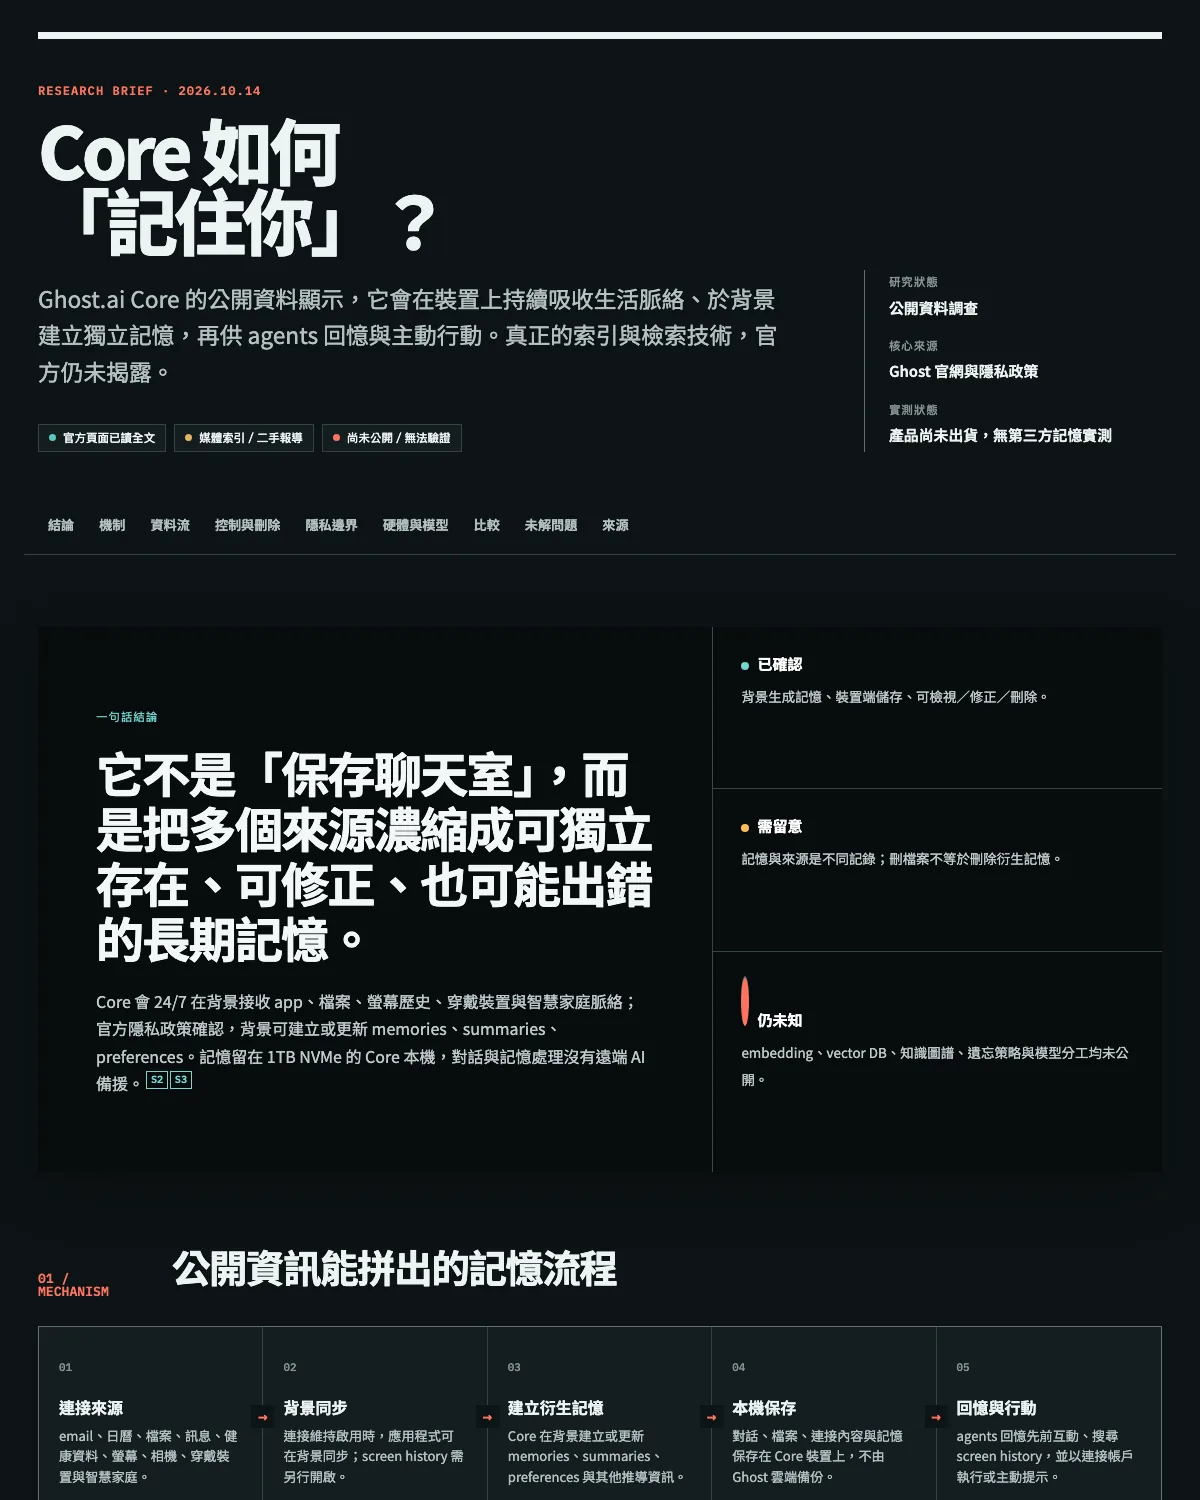
報告開頭先交代研究條件:
- 研究日期:2026-10-14
- 研究狀態:公開資料調查
- 核心來源:Ghost 官網與隱私政策
- 實測狀態:產品尚未出貨,沒有第三方記憶實測
然後每一條資訊都掛上三種標籤之一:官方頁面已讀全文、媒體索引/二手報導、尚未公開/無法驗證。
以下是報告內容。
一句話結論
它不是「保存聊天室」,而是把多個來源濃縮成可獨立存在、可修正、也可能出錯的長期記憶。
Core 會 24/7 在背景接收 app、檔案、螢幕歷史、穿戴裝置與智慧家庭的脈絡。官方隱私政策確認,背景可以建立或更新 memories、summaries、preferences。記憶留在 Core 本機的 1TB NVMe 裡,對話與記憶處理沒有遠端 AI 備援。
- 已確認:背景生成記憶、裝置端儲存、可檢視/修正/刪除。
- 需留意:記憶與來源是不同的記錄;刪檔案不等於刪除衍生記憶。
- 仍未知:embedding、vector DB、知識圖譜、遺忘策略與模型分工,均未公開。
公開資訊能拼出的記憶流程
- 連接來源:email、日曆、檔案、訊息、健康資料、螢幕、相機、穿戴裝置與智慧家庭。
- 背景同步:連接維持啟用時,應用程式可在背景同步;screen history 需要另外開啟。
- 建立衍生記憶:Core 在背景建立或更新 memories、summaries、preferences 與其他推導資訊。
- 本機保存:對話、檔案、連接內容與記憶保存在 Core 裝置上,不由 Ghost 雲端備份。
- 回憶與行動:agents 回憶先前互動、搜尋 screen history,並用連接的帳戶執行或主動提示。
報告在這裡劃了一條證據邊界:第 1–4 步有 Ghost 官網或隱私政策全文支持;「persistent memory 可供 agents recall」來自 The Neuron 對 setup guide 的轉述。官方沒有公開索引、向量檢索或記憶壓縮的實作細節。
它從哪裡取得「你的脈絡」
- 數位工作流:Email、日曆、聯絡人、訊息;文件、附件、任務結果;財務資料、錄音、瀏覽器;已存密碼與登入中的 sessions。
- 生活與健康:健康或 fitness records;Whoop、Oura、Eight Sleep;燈、冰箱、喇叭;攝影機、位置。
- 螢幕歷史:螢幕影像與辨識文字;應用程式、視窗標題、時間;可取得的頁面 URL。不錄音;private browsing 不會暫停擷取。
資料去哪裡,報告分成兩種:
- 本地:Ghost 政策說,conversations、files、connected-app content 與 memories 在 Core 本機儲存與處理,遠端模型不作為本地對話 AI 或記憶處理的 fallback。
- 線上功能例外:打電話、網路搜尋這類任務,資訊會經過 Ghost 的 managed-service gateway 送到第三方。Ghost 說 gateway 不保存資料庫、日誌或備份;但第三方仍可能依自家政策保留。
「關掉」與「刪掉」不是同一件事
這是整份報告最實用的一張表。
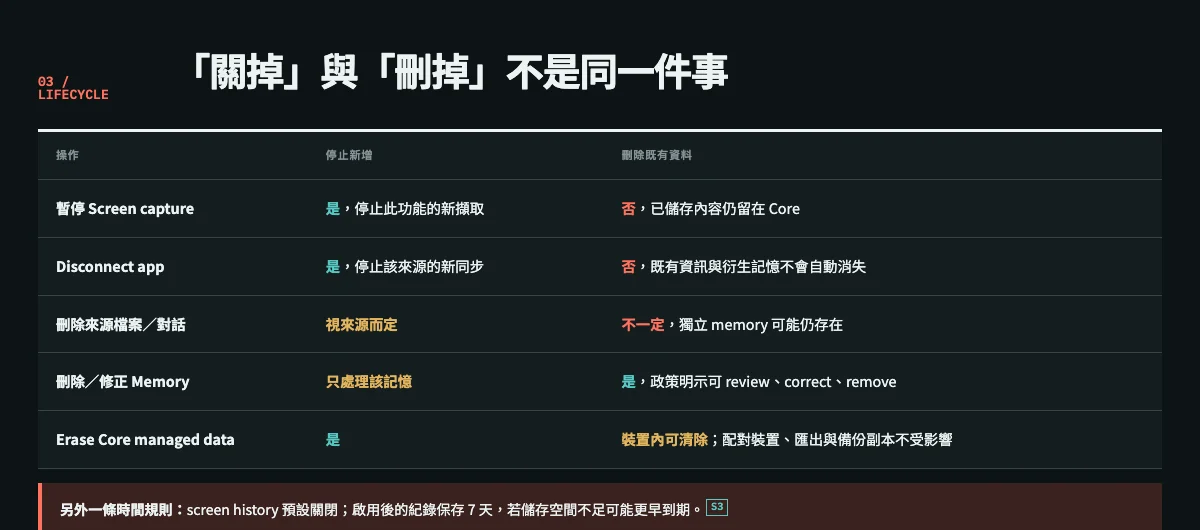
| 操作 | 停止新增 | 刪除既有資料 |
|---|---|---|
| 暫停 Screen capture | 是,停止此功能的新擷取 | 否,已儲存內容仍留在 Core |
| Disconnect app | 是,停止該來源的新同步 | 否,既有資訊與衍生記憶不會自動消失 |
| 刪除來源檔案/對話 | 視來源而定 | 不一定,獨立 memory 可能仍存在 |
| 刪除/修正 Memory | 只處理該記憶 | 是,政策明示可 review、correct、remove |
| Erase Core managed data | 是 | 裝置內可清除;配對裝置、匯出與備份副本不受影響 |
另外一條時間規則:screen history 預設關閉;啟用後的紀錄保存 7 天,儲存空間不足時可能更早到期。
「資料不離家」的承諾與邊界
官方首頁的說法是:「No data ever leaves your home.」首頁把 Core 描述為 entirely on device;創辦人也向 TechCrunch 表示,個資經過加密,包括 Ghost 在內的第三方都無法實質讀取。
但隱私政策揭露的實際邊界是:線上功能仍會把任務資訊交給第三方。 政策沒有重述「連 Ghost 都讀不到」的加密保證,也沒有公開加密演算法、金鑰生成、保管或恢復機制。
報告列出三個風險:
- Credential firewall 還沒完成:10 月 5 日報導時仍在打造中,用來監控 agents 的對外請求、阻擋未授權操作;目前沒有外部研究者測試過。
- 高價值資料集中:銀行、健康、攝影機與登入 session 匯聚在一台 24/7 開機的裝置上,評論者因此把它視為高價值攻擊目標。
- 還沒有獨立安全稽核:Ghost 表示歡迎安全公司稽核 gateway 與 relay,但公開資料裡看不到已完成的獨立稽核。
硬體已公開,記憶軟體棧沒有
| 項目 | 規格 |
|---|---|
| GPU | NVIDIA RTX PRO 4000 Blackwell SFF,24GB GDDR7 ECC,432 GB/s |
| CPU | AMD Ryzen 5 7600,6 核心/12 執行緒 |
| RAM | 64GB DDR5 |
| 儲存 | 1TB NVMe SSD |
| API | 支援 OpenAI Responses API 相容(第三方報導) |
預裝模型這裡,報告抓到一個不一致:TechCrunch 10/5 報導寫 3 個(Qwen 3.8-Next、Qwen 3.8-27B、Gemma 4-31B),10/14 的官網規格頁列了 4 個,多出一個 Muse-Glimmer-30B。是不是發表後才新增,官方沒有說明;它的開發者、授權、是否開源,也都沒有公開。
還有一段,報告特別寫明「不能從硬體規格推論的事」:沒有公開證據顯示 Core 用了 embeddings、vector DB、knowledge graph,或特定的 chunking/reranking 策略;也沒有資料說明哪個模型負責記憶的抽取、整合或檢索。
跟 ChatGPT、Claude 的記憶比
| 面向 | Ghost Core | ChatGPT | Claude |
|---|---|---|---|
| 記憶位置 | Core 裝置本地,無遠端 AI fallback | 雲端帳戶同步 | 雲端;Projects 為獨立空間 |
| 資料範圍 | apps、檔案、screen history、camera、wearables、smart home | 過去對話、已存資訊、檔案與連接 app,依方案/地區 | 過去對話與 Projects |
| 主動性 | 24/7 背景 agent,官方展示主動洞察 | 報導定位為被動回應為主 | 報導定位為被動回應為主 |
| 控制 | 可檢視/修正/刪除;逐來源開關;來源與記憶分開刪 | 可檢視/編輯/刪除;Temporary Chat 不建記憶 | 可開關;Incognito chats 不進記憶 |
報告的但書:ChatGPT/Claude 這兩欄來自第三方比較文章,不是這次用官方全文驗證的;方案與地區也可能改變。更重要的是,截至研究當天,沒有任何公開的 Core 記憶品質、準確率、召回率,或與 ChatGPT/Claude 的實測對比。
所以這張表的標題是:差異在架構,不代表記憶品質更好。
十個尚不能下結論的問題
- 索引技術:是否使用 embeddings、vector DB 或 knowledge graph?
- 記憶分類:是否區分 episodic/semantic memory?
- 更新與遺忘:記憶多久重整一次?何時衰減或合併?
- 模型分工:哪個模型負責抽取、檢索、整合與對話?
- 加密設計:演算法、金鑰持有人與恢復流程為何?
- Firewall 成效:仍在開發的 credential firewall 要怎麼驗證?
- 模型差異:官網多出的 Muse-Glimmer-30B 從何而來?
- 效能聲稱:87/32 tok/s 的第三方引述,找不到原始貼文。
- 記憶準確性:官方承認可能不準,卻沒有品質基準。
- 安全與對比:沒有獨立安全稽核,也沒有同業實測。
拿到實機後,最值得先驗收的六件事
- 來源刪除測試:建立可辨識的測試資料 → 生成記憶 → 刪除來源 → 檢查衍生記憶是否仍可被 recall。
- 記憶修正測試:刻意提供錯誤偏好後再修正,確認舊記憶是否被覆蓋、並停止影響後續回答。
- Screen history 測試:關閉擷取、private browsing、7 天到期,各自驗證,不只看設定畫面。
- 網路流量測試:分別執行純本地對話、web search 與電話,觀察哪些目的地收到任務資訊。
- 配對裝置副本:從手機檢視/下載內容後,確認副本位置,以及是否進入手機或雲端備份。
- 登入憑證權限:用低權限的測試帳號,確認 agent 的操作範圍、阻擋行為與審查紀錄。
報告註明:這些是依 Ghost 公開揭露的生命週期與風險邊界整理的驗收建議,不代表已經對 Core 做過測試。
這份報告做對的四件事
這段是我的觀察,不是報告寫的。
1. 每條資料都標查證層級。
三種標籤,每段後面都掛來源編號(S1–S11)。你一眼就知道哪句是讀過官方全文、哪句是二手轉述、哪句根本沒人能證實。
2. 查不到,就寫查不到。
報告的方法說明裡有一句:所有技術空白均維持未驗證,不以一般 RAG 架構推測 Ghost 的實作。
這句最值錢。
AI 最常犯的錯,是拿通用知識把空白補滿。看起來很完整,其實是猜的。Core 的記憶「應該」是 embedding+向量資料庫——這種話隨手就能寫出來,報告偏偏不寫。
3. 抓到來源之間的矛盾,不自己挑一邊。
TechCrunch 寫 3 個模型,官網列 4 個。報告沒有選一個信,而是把差異攤開,再列進「未解問題」。
4. 結尾給驗收清單,不給評分。
它沒說 Core 的記憶好或不好。它說的是:拿到機器之後,你自己怎麼驗。
這也是你用任何深度研究工具時該要的東西——不是一個結論,是一份讓你自己能下結論的清單。
你也可以這樣做:研究提示詞
先說明:這不是我當時給 Muse 的原始提示詞,是本站照這份報告的結構反推出來的版本。可以貼給 Muse,也可以貼給 ChatGPT 或 Gemini 的深度研究。
最後一條「不替我下最終判斷」,是本站加的規則。
研究主題:[公司/產品名稱]的[你想看懂的機制,例如:記憶機制]

請只用公開網路資料研究,並遵守以下規則:

1. 每一條重要資訊都標出查證層級:
   - 官方頁面已讀全文(附網址與讀取日期)
   - 媒體索引/二手報導(附網址)
   - 尚未公開/無法驗證
2. 官方沒有公開的技術細節,一律寫「未公開」,不要用一般業界做法推測補上。
3. 不同來源說法不一致時,把兩邊都列出來,不要自己挑一個。
4. 區分「官方宣稱」和「政策/文件實際揭露的邊界」。
5. 報告結構:
   - 一句話結論(分成:已確認/需留意/仍未知)
   - 運作流程(每一步標出證據來源)
   - 資料從哪裡來、存在哪裡、什麼時候會離開裝置
   - 使用者能控制什麼:「停止新增」和「刪除既有資料」分開說明
   - 風險與尚未驗證的承諾
   - 尚不能下結論的問題(至少 5 個)
   - 拿到實物後最值得先驗收的測試(每項寫出具體步驟)
   - 來源清單(標註查證層級)
6. 報告只整理證據,不替我下「值不值得買/值不值得用」的最終判斷。
常見問題
Q:Meta Muse 的深度研究看得到我的帳號和對話嗎?
依 Muse 自己的說明,看不到。研究 agent 在登出狀態的瀏覽器裡跑公開網頁,看不到你跟 Muse 的對話、沒有你的記憶和帳號,也不會登入任何網站。
Q:要登入或付費牆後面的資料,Muse 查得到嗎?
查不到。這是 Muse 自己講明的限制。關鍵資料在登入牆或付費牆後面的題目,要換別的方法。
Q:Muse 跟 ChatGPT/Gemini 的深度研究,最大差別是什麼?
Muse 說差在工作流:研究跑完回到它手上可以接著做事、研究結果帶著對你的了解來解讀、追加問題餵給同一個任務繼續挖。這是 Muse 的自述,本站沒有把三家放在一起實測。
Q:在 Ghost Core 上刪掉一個檔案,相關的記憶會一起消失嗎?
不一定。依報告整理的隱私政策,記憶與來源是不同的記錄,獨立的 memory 可能仍然存在。要刪記憶,得另外對 Memory 做刪除或修正。
Q:Ghost Core 的記憶是用向量資料庫做的嗎?
未公開。報告找不到任何公開證據顯示 Core 用了 embeddings、vector DB 或 knowledge graph,也刻意不拿一般 RAG 架構去推測。
來源
報告列出的來源與查證層級:
- S1 TechCrunch · 2026-10-05:索引開啟全文;創辦人說法、產品定位、模型與 firewall 開發狀態。
- S2 Ghost 官網首頁、Core 規格頁:2026-10-14 已讀全文;continuous context、資料來源、硬體與模型。
- S3 Ghost 隱私政策:2026-10-14 已讀全文;生效日 2026-10-05。記憶、資料流、控制與限制的主要一手來源。
- S4 The Neuron:搜尋索引/二手;轉述 setup guide 的 persistent memory 與 recall。
- S5 Timesng:搜尋索引/評論;「資料不離家」例外與集中風險。
- S6 devcuration:搜尋索引/評論;無獨立安全稽核、firewall 仍在開發。
- S7 startuply.vc:搜尋索引/評論;單點故障與硬體模型上限風險。
- S8 The Weighted Average:搜尋索引/分析;建議以刪除測試驗收資料生命週期。
- S9 TechRadar(經 realhacker.news 轉載):搜尋索引/轉載;本地 AI box 的定位與隱私評論。
- S10 第三方競爭分析文件:搜尋索引;吞吐量為間接引述,未作確認值使用。
- S11 Lumichats、ClickUp:搜尋索引/第三方比較;ChatGPT 與 Claude 記憶功能摘要。
報告的方法說明:只採用公開網路來源。標示「官方頁面已讀全文」的資料,研究代理在 2026-10-14 實際讀取過頁面;「搜尋索引/二手」沒有完成同等的全文驗證,所以保留來源層級。所有技術空白均維持未驗證。
Author
AI-MAN
Related Posts